AI资讯新闻榜单内容搜索-多模态

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 多模态
何恺明团队发布多模态Harness框架

何恺明团队发布多模态Harness框架

何恺明团队发布多模态Harness框架

多模态模型的视觉原生Harness,来了!

来自主题: AI技术研报
8851 点击    2026-10-09 12:02
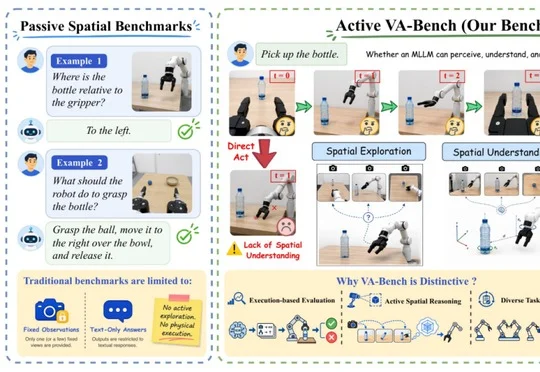
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
来自主题: AI技术研报
9231 点击    2026-10-05 23:29
MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做

MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做

MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做

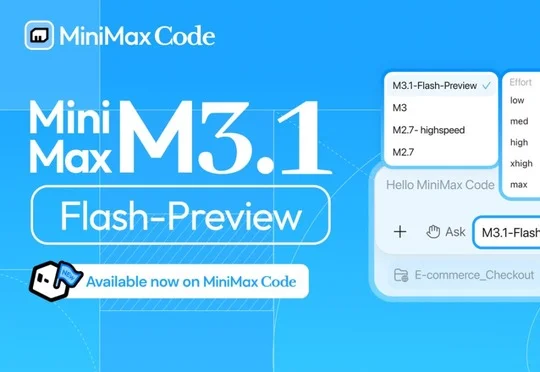
六天后的 9 月 28 日,MiniMax 上线了 M3.1-Flash-Preview。这是 M 系列的最新模型,百万 token 上下文、原生多模态,在 MiniMax Code 里首发上线,目前也可以通过 API 订阅套餐调用。
来自主题: AI资讯
8041 点击    2026-10-03 10:30
银河通用智能体机器人价格公布,7.9万起

银河通用智能体机器人价格公布,7.9万起

银河通用智能体机器人价格公布,7.9万起

能跟人类舞者Battle的机器人,有点意思。不仅能实时斗舞、学习能力也一流,动作看一遍就能复刻,连托马斯都转上了。银河星仔ET1,舞技了得~这是银河首创全自研物理世界原生智能体,专为人形机器人实时多模态交互和运动打造。
来自主题: AI资讯
9371 点击    2026-10-02 12:50
首发!openJiuwen WorkSwarm全双工多模态 ,像聊天一样与Agent交互,昇腾算力原生亲和

首发!openJiuwen WorkSwarm全双工多模态 ,像聊天一样与Agent交互,昇腾算力原生亲和

首发!openJiuwen WorkSwarm全双工多模态 ,像聊天一样与Agent交互,昇腾算力原生亲和

openJiuwen WorkSwarm首发全双工多模态能力,实现用户在前台像聊天一样随时与Agent交互、插话和追问,复杂任务则交给后台Core Agent独立执行,且原生亲和昇腾算力,支持基于华为云ModelArts与vLLM-Omni框架在昇腾NPU上部署。
来自主题: AI资讯
10132 点击    2026-10-01 16:20
「寰宇心生 WorldMind」完成数千万种子轮融资,点石资本担任独家财务顾问 | 点石交易

「寰宇心生 WorldMind」完成数千万种子轮融资,点石资本担任独家财务顾问 | 点石交易

「寰宇心生 WorldMind」完成数千万种子轮融资,点石资本担任独家财务顾问 | 点石交易

寰宇心生(WorldMind)于成立当月完成数千万元人民币种子轮融资,元生资本为投资方,点石资本担任独家财务顾问,所融资金将用于神经认知世界模型研发、训练基础设施建设、多模态数据采集体系搭建及团队扩张。
来自主题: AI资讯
8225 点击    2026-09-29 11:16
比Jev快2-3倍的国产开源模型来了:Intern-Decision拿下多模态决策SOTA

比Jev快2-3倍的国产开源模型来了:Intern-Decision拿下多模态决策SOTA

比Jev快2-3倍的国产开源模型来了:Intern-Decision拿下多模态决策SOTA

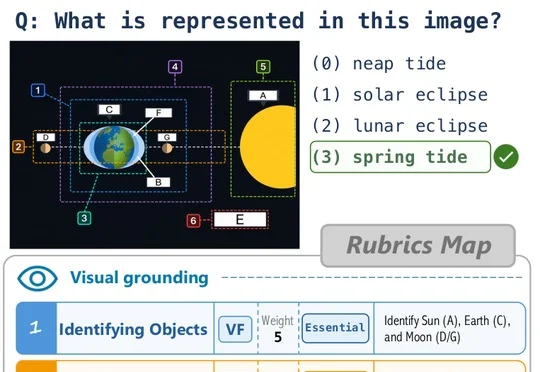
上海人工智能实验室开源的多模态决策SOTA模型Intern-Decision采用自回归式掩码语言任务框架,在推理速度上比Jev提升2至3倍,并在游戏画面决策、验证码识别和网页操作等任务中展现出将视觉理解与结构化决策结合的能力,目前已在Hugging Face、GitHub开源0.8B、2B和4B三个版本。
来自主题: AI资讯
9501 点击    2026-09-29 11:14
答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励

答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励

答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励

南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
来自主题: AI技术研报
7942 点击    2026-09-28 09:48
华为大模型双子星联手创业,息壤开物要找物理世界的Scaling Law

华为大模型双子星联手创业,息壤开物要找物理世界的Scaling Law

华为大模型双子星联手创业,息壤开物要找物理世界的Scaling Law

前华为云盘古大模型CTO李寅与多模态首席科学家张含望联合创立的息壤开物宣布完成数亿元种子轮及天使轮融资(估值5亿美金),旨在训练面向物理世界的大物理模型(LPM),寻找物理世界的Scaling Law。
来自主题: AI资讯
8923 点击    2026-09-26 14:57
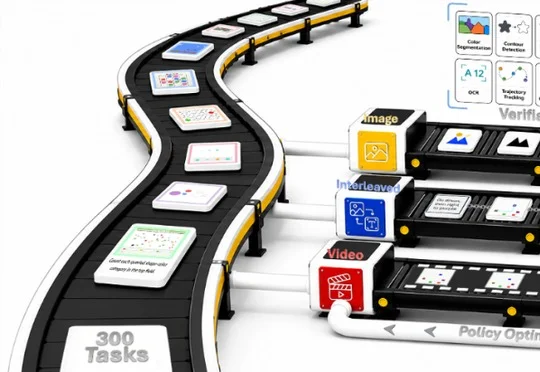
给视频模型建一座「全能训练场」:300项任务、可验证奖励,VBVR-Pro系统探索视觉推理

给视频模型建一座「全能训练场」:300项任务、可验证奖励,VBVR-Pro系统探索视觉推理

给视频模型建一座「全能训练场」:300项任务、可验证奖励,VBVR-Pro系统探索视觉推理

NTU、CMU、Berkeley等高校联合推出VBVR-Pro视觉推理系统,构建300项任务与100项可验证打分器的训练评测平台,测试30余个多模态模型,并验证其打分器可直接作为强化学习奖励。

来自主题: AI技术研报
7603 点击    2026-09-20 15:08