何恺明团队发布多模态Harness框架
何恺明团队发布多模态Harness框架多模态模型的视觉原生Harness,来了!
来自主题: AI技术研报
8863 点击 2026-10-09 12:02

 搜索
多模态模型的视觉原生Harness,来了!
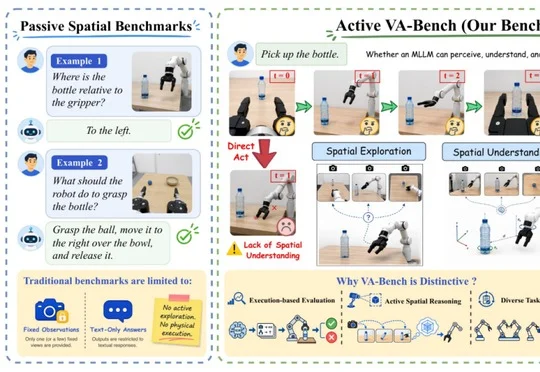
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
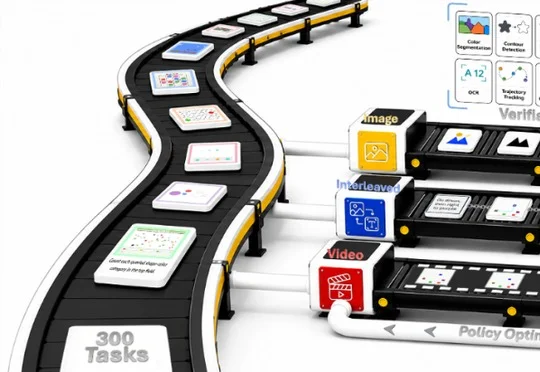
NTU、CMU、Berkeley等高校联合推出VBVR-Pro视觉推理系统,构建300项任务与100项可验证打分器的训练评测平台,测试30余个多模态模型,并验证其打分器可直接作为强化学习奖励。
10B参数以内,空间具身能力同档第一的通用多模态大模型来了!
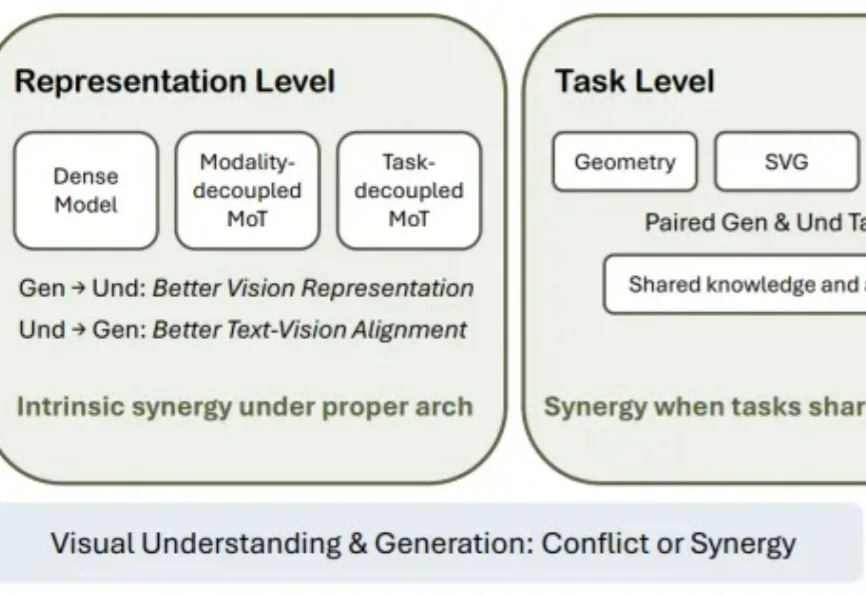
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
视觉编程成绩超GPT-5.4。
多模态模型的空间推理,有一种很反直觉的现象:它能看懂图里有什么,也能回答简单的左右上下,却会在换视角、判断方位、推理前后关系时突然失灵。
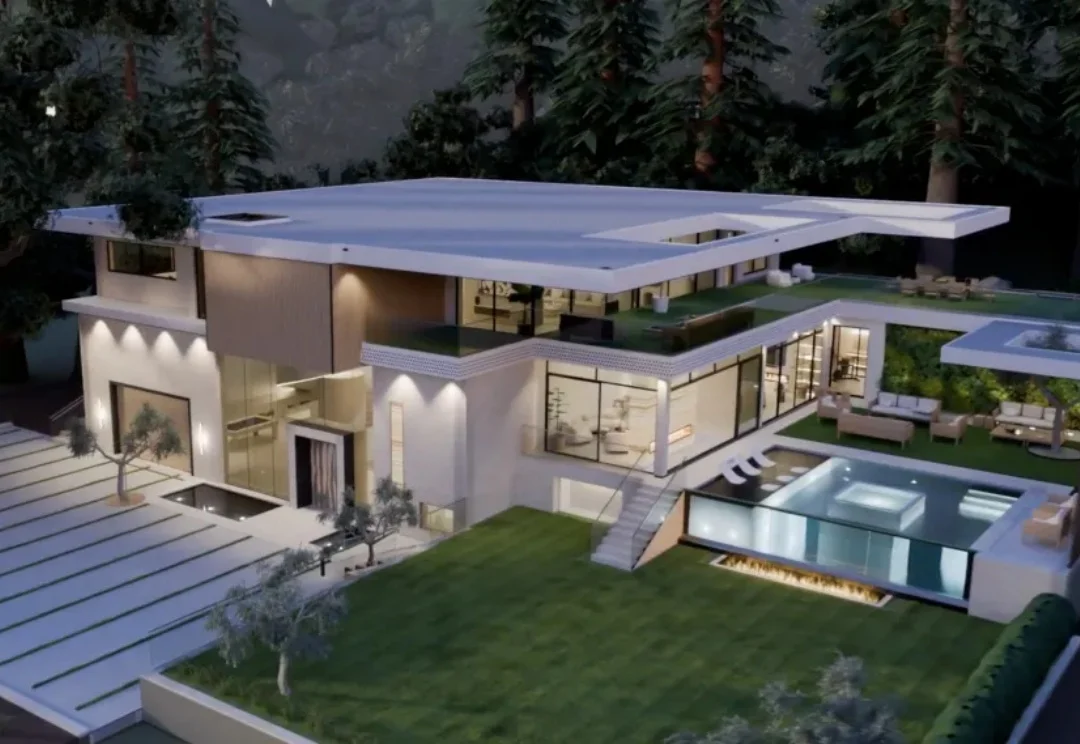
最近,GPT-6 Astra 的三维建模与空间理解 demo 引发关注。它能在 Blender 中搭建带家具和庭院的住宅,再将场景转入 Unreal Engine 5,让人能走进房间、打开柜门,甚至操作咖啡机。
DeepSeek-V4-Flash-Vision-Exp多模态模型正式开源,该模型为DeepSeek-V4系列首个实验性多模态模型,基于DeepSeek-V4-Flash架构集成视觉模块,在真实世界软件工程测试DeepSWE中以59.3%反超Opus-4.8登顶,并在零样本视觉推理测试ZeroBench中击败Opus-4.8。
今天,我们上线并开源GLM-5.3-Flash (320B-A18B),这是GLM-5系列的首个原生多模态模型。大家好像已经习惯将前沿智能与前沿价格绑定,并认为这是技术进步必须支付的成本。今天,GLM-5.3-Flash来了:320B总参数,能力超过GLM-5.2,在全球权威的Artificial Analysis Intelligence Index(AA综合智能指数)中取得57分