AI资讯新闻榜单内容搜索-大模

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 大模
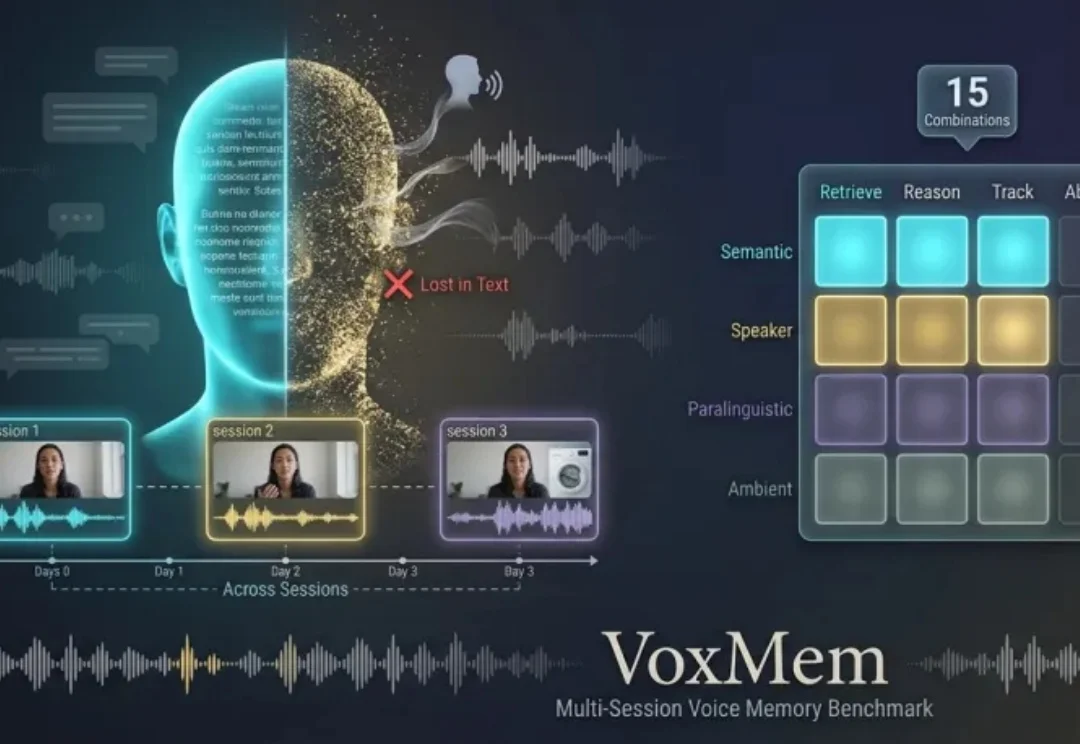
多会话语音记忆基准VoxMem,专治音频大模型记不住「谁说的、怎么说」

多会话语音记忆基准VoxMem,专治音频大模型记不住「谁说的、怎么说」

多会话语音记忆基准VoxMem,专治音频大模型记不住「谁说的、怎么说」

在语音助手、多用户共享的家庭助理等长期对话场景中,模型需要跨越多次会话记住用户的信息,但现有评测常遭遇两大难题:

来自主题: AI技术研报
8692 点击    2026-10-09 16:23
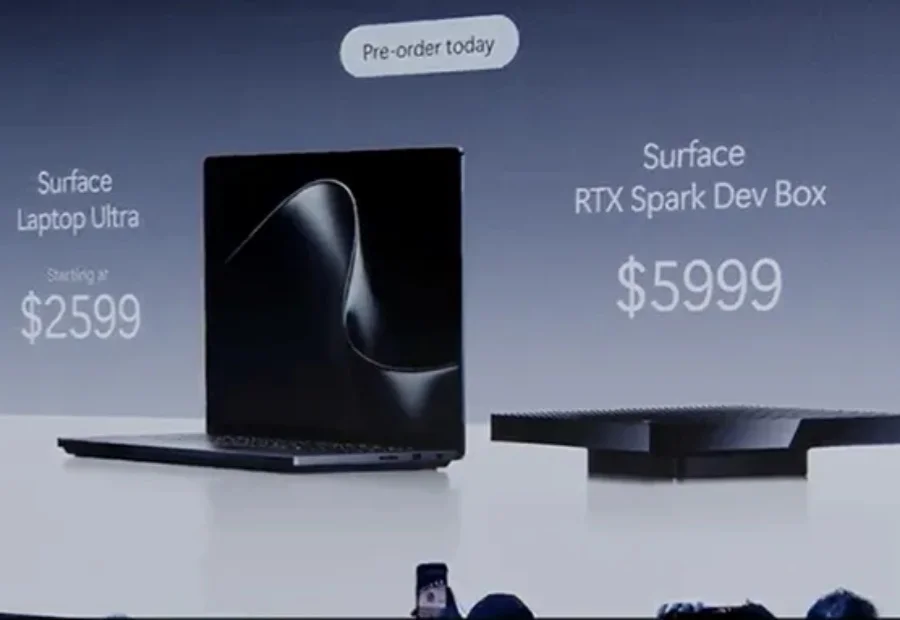
首款RTX Spark电脑,开卖!可跑1200亿参数大模型

首款RTX Spark电脑,开卖!可跑1200亿参数大模型

首款RTX Spark电脑,开卖!可跑1200亿参数大模型

最高20核CPU、6144核GPU、128GB统一内存、1PFLOPS本地AI算力。
来自主题: AI资讯
7245 点击    2026-10-08 12:14
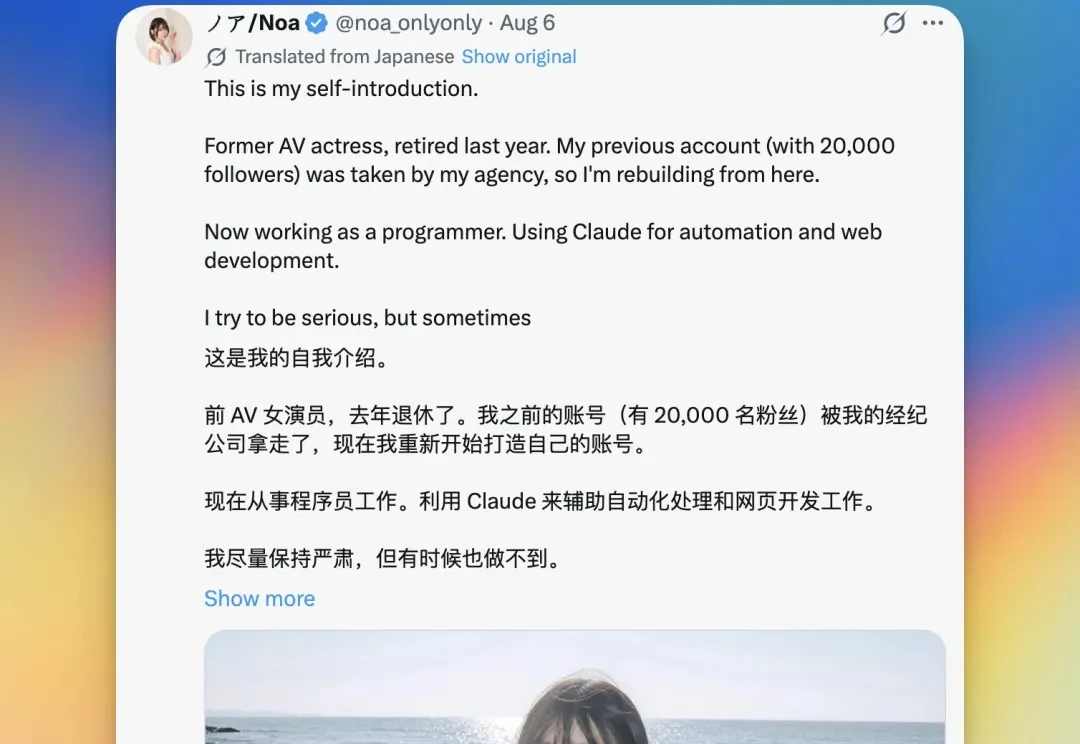
一群日本 AV 女优和歌手,正在偷家大厂 AI 产品经理

一群日本 AV 女优和歌手,正在偷家大厂 AI 产品经理

一群日本 AV 女优和歌手,正在偷家大厂 AI 产品经理

在这个被大模型和 AI 融资神话包裹的 2026 年,如果有人问:谁是国内大厂 AI 产品经理最危险的竞争对手?
来自主题: AI资讯
9615 点击    2026-10-08 11:51
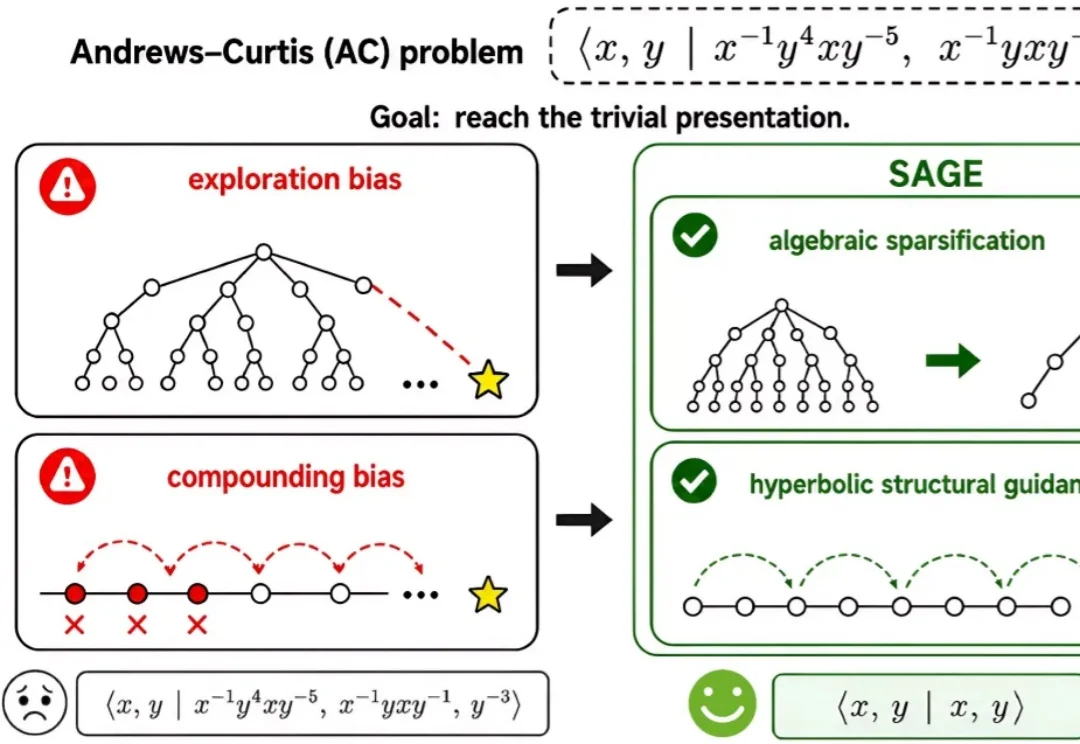
NeurIPS 2026 | 长推理为何总在中途走偏?SAGE用结构信号纠偏,AC实例验证通过率接近8倍

NeurIPS 2026 | 长推理为何总在中途走偏?SAGE用结构信号纠偏,AC实例验证通过率接近8倍

NeurIPS 2026 | 长推理为何总在中途走偏?SAGE用结构信号纠偏,AC实例验证通过率接近8倍

大模型解短题常能给出流畅答案,推理链一长,却可能每一步都看似合理、终点仍然失效。来自弗吉尼亚理工大学、威斯康星大学麦迪逊分校和达特茅斯学院的研究团队在 NeurIPS2026 论文中提出 SAGE:用符号闭包分析(SCA)解释长推理中的探索偏差与累积偏差,再把这一诊断变成训练时的结构引导。
来自主题: AI技术研报
8869 点击    2026-10-08 11:26
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

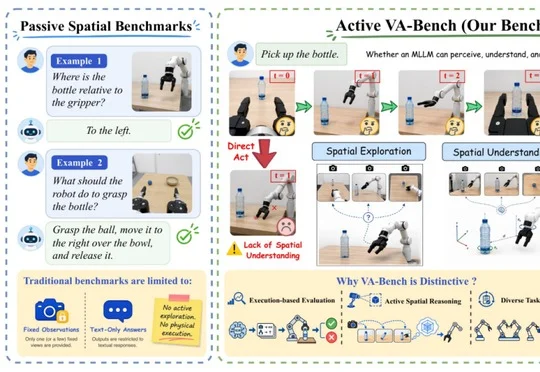
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
来自主题: AI技术研报
9248 点击    2026-10-05 23:29
放养AI练棋,Claude暴涨250分!GPT-6越练越菜

放养AI练棋,Claude暴涨250分!GPT-6越练越菜

放养AI练棋,Claude暴涨250分!GPT-6越练越菜

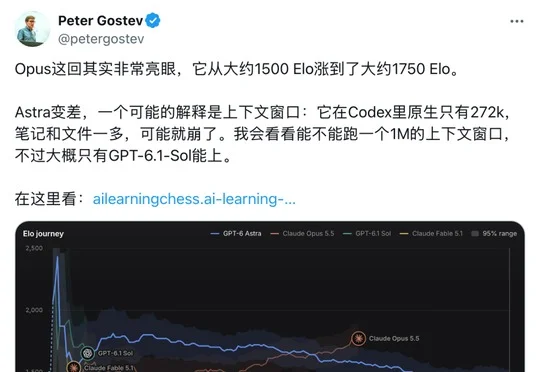
大模型竞技场Arena让Claude Opus 5.5与GPT-6 Astra各自练棋200局,前者估算评分从约1500升至1760,后者从第29盘的1810降至1400,显示AI仅靠记录与复盘提升能力的表现并不一致。
来自主题: AI资讯
8556 点击    2026-10-05 23:29
SocioVerse2:长程推演的社会模拟实验基地,让研究者和智能体携手进化

SocioVerse2:长程推演的社会模拟实验基地,让研究者和智能体携手进化

SocioVerse2:长程推演的社会模拟实验基地,让研究者和智能体携手进化

来自上海创智学院、复旦大学、伦敦国王学院与牛津大学等机构的研究团队推出SocioVerse2,将大模型社会模拟扩展为可干预、可迭代、可回溯的开源社会科学研究框架。
来自主题: AI技术研报
8588 点击    2026-10-05 23:29
深度|百亿美金AI法律Harvey联创:应用公司不必与大模型比拼资金和算力,但要借助开源建立研究能力

深度|百亿美金AI法律Harvey联创:应用公司不必与大模型比拼资金和算力,但要借助开源建立研究能力

深度|百亿美金AI法律Harvey联创:应用公司不必与大模型比拼资金和算力,但要借助开源建立研究能力

Harvey联合创始人Gabe Pereyra表示,AI应用公司不必与大模型公司比拼资金和算力,可借助真实任务评测、领域专家、开源模型和外部研究团队建立持续学习能力。
来自主题: AI资讯
8985 点击    2026-10-05 23:28
万分之一——大模型后训练中的极端稀疏监督

万分之一——大模型后训练中的极端稀疏监督

万分之一——大模型后训练中的极端稀疏监督

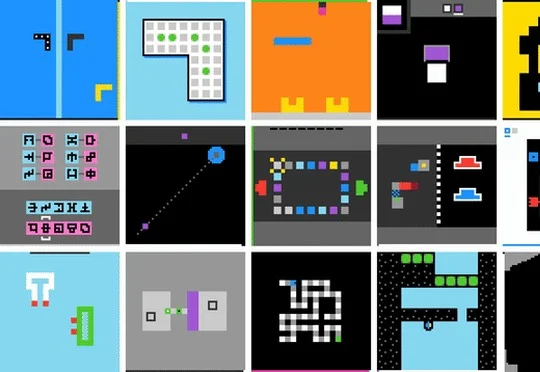
亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
来自主题: AI技术研报
8558 点击    2026-10-04 22:03
Claude满分、GPT 99分!何恺明团队把AGI考试打穿了

Claude满分、GPT 99分!何恺明团队把AGI考试打穿了

Claude满分、GPT 99分!何恺明团队把AGI考试打穿了

何恺明团队提出VISTA方法,将ARC-AGI-3的数字表换回图像并配备可随时翻看的视觉记忆相册,使Claude Opus 5拿下满分100分、GPT-5.6 Sol获得99分,证明卡住大模型的是眼睛和记性而非模型能力本身。

来自主题: AI资讯
7978 点击    2026-10-04 22:03