openJiuwen X-Router自演进模型路由技术首发,昇腾亲和,Agent越跑越省,实测减少50+%Token消耗
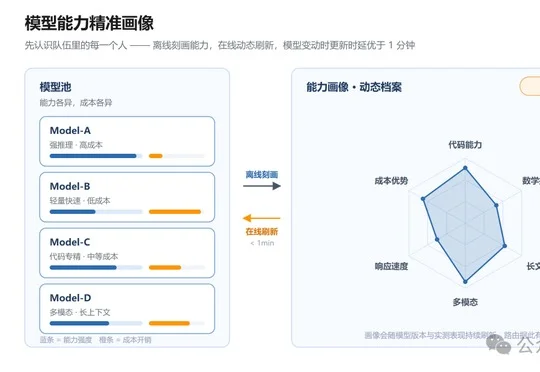
openJiuwen X-Router自演进模型路由技术首发,昇腾亲和,Agent越跑越省,实测减少50+%Token消耗不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。
搜索
不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。
openJiuwen WorkSwarm首发全双工多模态能力,实现用户在前台像聊天一样随时与Agent交互、插话和追问,复杂任务则交给后台Core Agent独立执行,且原生亲和昇腾算力,支持基于华为云ModelArts与vLLM-Omni框架在昇腾NPU上部署。
DeepSeek开源面向华为昇腾算力平台的基础设施组件,涵盖TileLang编译工具及DeepGEMM、DeepEP、TileKernels、FlashMLA、DeepSelect等计算与通信库,华为亦在CANN社区开源双方围绕昇腾950及超节点的联合创新实践。
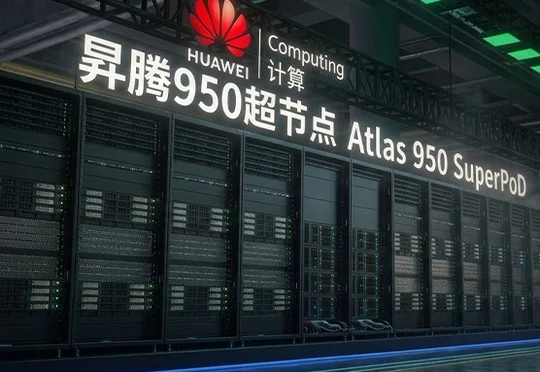
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
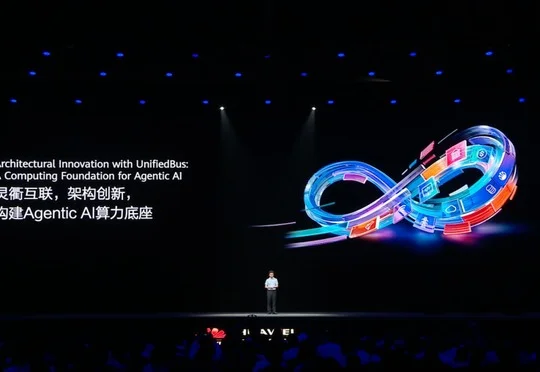
在华为2026年全联接大会上,华为发布"灵衢"统一互联总线协议及昇腾960超节点、OceanStor M900 AI记忆存储等AI基础设施新品,使10万卡集群模型浮点算力利用率从20%提升至35%,并支持单集群100万颗AI处理器。
华为今年全联接大会,最重磅的首先是一组芯片时间表。昇腾960DT研发进度比原计划提前三个季度,单芯片算力实现倍增,960DT支持2 PFLOPS FP8、4 PFLOPS FP4,HBM容量最高288GB、带宽9.6TB/s。
openJiuwen首发双维度RSI框架,在WorkSwarm蜂群办公智能体上落地Harness与Artifacts双维度优化,支持科研论文和算法程序两类交付产物迭代,并依托昇腾算力亲和能力降低多轮优化的时延与资源开销。
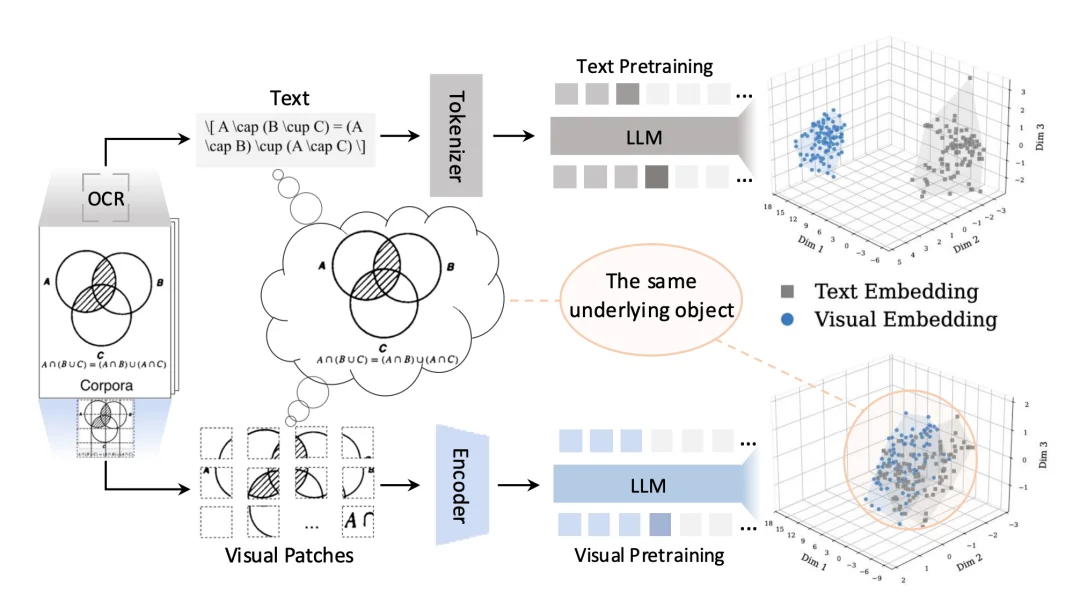
近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。
目前,这项技术已成功应用于上海人工智能实验室Intern-S2-Preview 35B/397B系列多模态大模型的预训练中,有效提升了模型的科学推理与多模态理解能力。值得一提的是,相关研发均基于国产昇腾算力平台完成,并成功实现了面向大规模预训练的深度适配与优化。
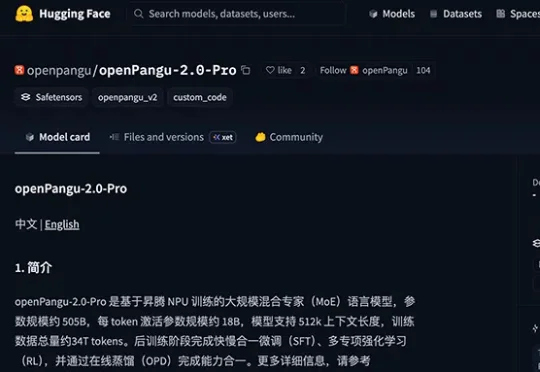
今日,华为开源基于昇腾NPU训练的盘古MoE模型openPangu-2.0-Pro。该模型是openPangu-2.0系列的最新开源模型,总参数规模5050亿,激活参数规模180亿,支持512K上下文长度,训练数据总量约34T tokens。另一轻量化模型openPangu-2.0-Flash已于6月12日开源,参数92亿,其中6亿为激活参数。