大模型压缩量化方案怎么选?无问芯穹Qllm-Eval量化方案全面评估:多模型、多参数、多维度
大模型压缩量化方案怎么选?无问芯穹Qllm-Eval量化方案全面评估:多模型、多参数、多维度基于 Transformer架构的大型语言模型在各种基准测试中展现出优异性能,但数百亿、千亿乃至万亿量级的参数规模会带来高昂的服务成本。例如GPT-3有1750亿参数,采用FP16存储,模型大小约为350GB,而即使是英伟达最新的B200 GPU 内存也只有192GB ,更不用说其他GPU和边缘设备。
搜索
基于 Transformer架构的大型语言模型在各种基准测试中展现出优异性能,但数百亿、千亿乃至万亿量级的参数规模会带来高昂的服务成本。例如GPT-3有1750亿参数,采用FP16存储,模型大小约为350GB,而即使是英伟达最新的B200 GPU 内存也只有192GB ,更不用说其他GPU和边缘设备。
早在 2020 年,陶大程团队就发布了《Knowledge Distillation: A Survey》,详细介绍了知识蒸馏在深度学习中的应用,主要用于模型压缩和加速。随着大语言模型的出现,知识蒸馏的作用范围不断扩大,逐渐扩展到了用于提升小模型的性能以及模型的自我提升。
模型量化是模型压缩与加速中的一项关键技术,其将模型权重与激活值量化至低 bit,以允许模型占用更少的内存开销并加快推理速度。对于具有海量参数的大语言模型而言,模型量化显得更加重要。
近期,清华大学和哈尔滨工业大学联合发布了一篇论文:把大模型压缩到 1.0073 个比特时,仍然能使其保持约 83% 的性能!
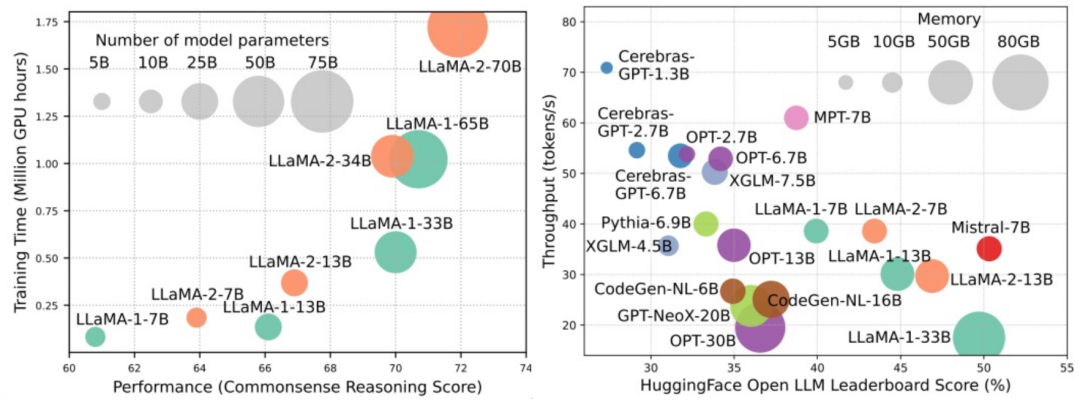
大规模语言模型(LLMs)在很多关键任务中展现出显著的能力,比如自然语言理解、语言生成和复杂推理,并对社会产生深远的影响。然而,这些卓越的能力伴随着对庞大训练资源的需求(如下图左)和较长推理时延(如下图右)。因此,研究者们需要开发出有效的技术手段去解决其效率问题。
联想发布首款AI PC!AI PC能够创建个性化的本地知识库,通过模型压缩技术运行个人大模型,实现AI自然交互。这意味着AI PC不仅可以自动化完成许多繁琐的任务,提高工作效率,还能根据用户的需求和习惯进行个性化定制,让工作变得更加智能、便捷。