AI资讯新闻榜单内容搜索-模型训练

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 模型训练
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。

来自主题: AI技术研报
9227 点击    2026-10-05 23:29
SocioVerse2:长程推演的社会模拟实验基地,让研究者和智能体携手进化

SocioVerse2:长程推演的社会模拟实验基地,让研究者和智能体携手进化

SocioVerse2:长程推演的社会模拟实验基地,让研究者和智能体携手进化

来自上海创智学院、复旦大学、伦敦国王学院与牛津大学等机构的研究团队推出SocioVerse2,将大模型社会模拟扩展为可干预、可迭代、可回溯的开源社会科学研究框架。
来自主题: AI技术研报
8564 点击    2026-10-05 23:29
魔搭开源动态检索新框架,无需预构建向量索引,知识库还能自己进化

魔搭开源动态检索新框架,无需预构建向量索引,知识库还能自己进化

魔搭开源动态检索新框架,无需预构建向量索引,知识库还能自己进化

ModelScope团队开源动态检索框架Sirchmunk,无需预构建向量索引即可在原始文件中即时定位证据,并通过KnowledgeEvolver把检索经验沉淀为可复用知识,使知识库在检索过程中持续连接、合并与重组,实现自我进化。
来自主题: AI技术研报
9014 点击    2026-10-04 22:06
万分之一——大模型后训练中的极端稀疏监督

万分之一——大模型后训练中的极端稀疏监督

万分之一——大模型后训练中的极端稀疏监督

亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
来自主题: AI技术研报
8512 点击    2026-10-04 22:03
Jev火了,NeurIPS 2025的ConfTuner早已探索相似思路

Jev火了,NeurIPS 2025的ConfTuner早已探索相似思路

Jev火了,NeurIPS 2025的ConfTuner早已探索相似思路

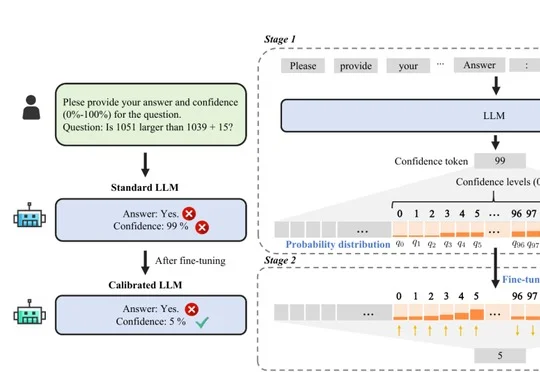
TypeSafe AI推出的Jev模型因直接输出决策与概率火爆出圈,其技术思路与NeurIPS 2025入选论文ConfTuner高度一致,后者通过Tokenized Brier Score直接训练候选置信度概率分布以实现概率校准。
来自主题: AI技术研报
9123 点击    2026-10-04 22:02
CoRL 2026|让机器人更会动,从学会「起步」开始

CoRL 2026|让机器人更会动,从学会「起步」开始

CoRL 2026|让机器人更会动,从学会「起步」开始

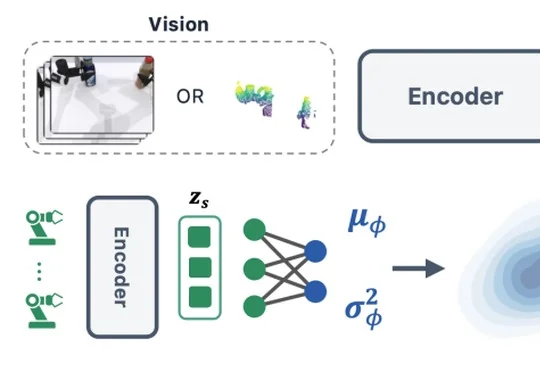
东南大学魏秀参团队提出LeaP(Learnable source Prior)方法,由本体感知信息驱动并联合预测动作生成起点的均值与方差,在RoboTwin仿真15项任务上平均成功率81.6%、较标准高斯基线提升25.5个百分点,相关论文已被CoRL 2026接收。
来自主题: AI技术研报
9321 点击    2026-10-04 22:01
Agent Harness到底怎么选?南洋理工大学安波团队最新研究给出答案

Agent Harness到底怎么选?南洋理工大学安波团队最新研究给出答案

Agent Harness到底怎么选?南洋理工大学安波团队最新研究给出答案

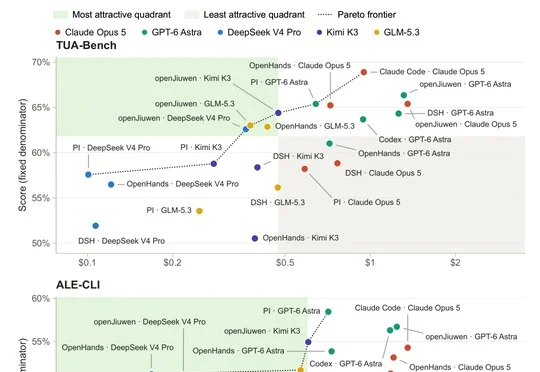
南洋理工大学安波团队最新研究指出,Agent Harness的选型应将模型、Harness与任务作为完整配置联合评估,不同任务下最佳组合会变化,原生搭配也未必优于其他可配置Harness。
来自主题: AI技术研报
8776 点击    2026-10-04 22:01
让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

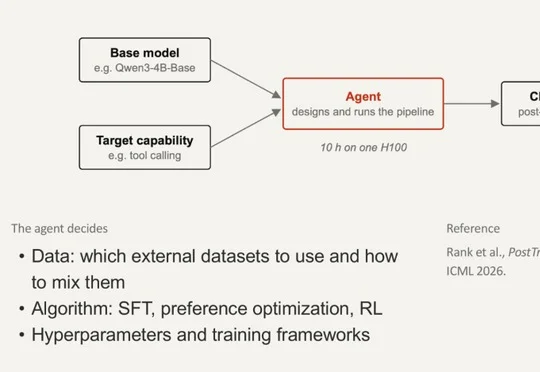
给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain
来自主题: AI技术研报
9060 点击    2026-10-03 10:29
把Depth Anything砍到6M,深度估计终于能跑进Jetson

把Depth Anything砍到6M,深度估计终于能跑进Jetson

把Depth Anything砍到6M,深度估计终于能跑进Jetson

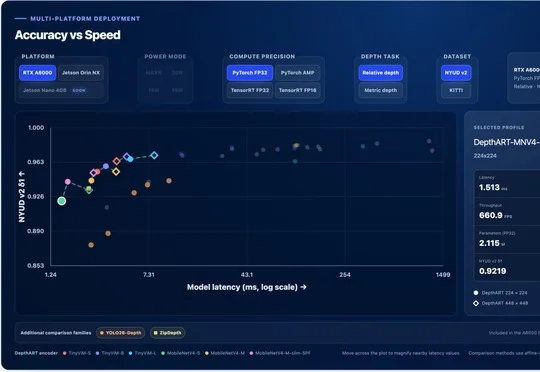
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
来自主题: AI技术研报
9064 点击    2026-10-03 10:28
LegoFlow:让智能体自主跑完代码数据构建+训练测评全流程

LegoFlow:让智能体自主跑完代码数据构建+训练测评全流程

LegoFlow:让智能体自主跑完代码数据构建+训练测评全流程

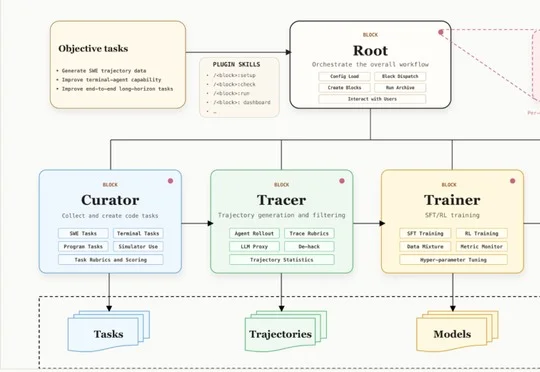
从 1200 万个候选拉取请求中,最终留下 5000 个 SWE 代码任务 —— 不足 0.05%。把「出题、答题、改卷、训练、评测」这条代码数据流水线全自动跑起来,就是 LegoFlow; 在这个过

来自主题: AI技术研报
8140 点击    2026-10-03 10:27