宇树风波后,具身智能还值得相信吗?顶级机器人学者Sergey Levine指明方向
宇树风波后,具身智能还值得相信吗?顶级机器人学者Sergey Levine指明方向Physical Intelligence联合创始人Sergey Levine指出,机器人尚未进入稳定缩放阶段,应以先验知识、有效决策循环和多样化数据提升泛化与可靠性,并在找到真正可规模化的技术后扩大投入。
来自主题: AI资讯
9372 点击 2026-10-05 23:29

 搜索
Physical Intelligence联合创始人Sergey Levine指出,机器人尚未进入稳定缩放阶段,应以先验知识、有效决策循环和多样化数据提升泛化与可靠性,并在找到真正可规模化的技术后扩大投入。
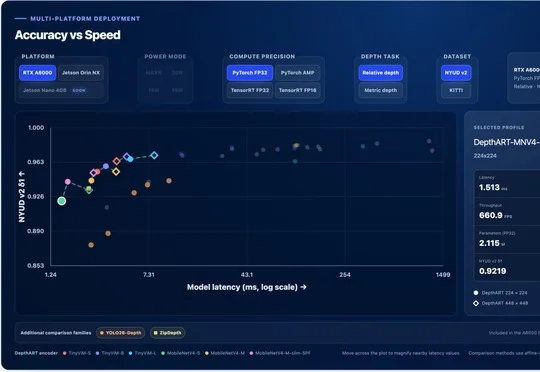
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
本周「十字路口」的嘉宾是清华叉院助理教授徐梦迪。从清华车辆工程出发,途经 Johns Hopkins、CMU,再到 Stanford 吴佳俊、李飞飞组做博士后,2024 年初她选择回国,加入清华交叉信息研究院。她的核心命题是机器人的 In-Context Learning (ICL):让机器人到一个新环境,通过一两次交互当场学会新任务,而且越学越快。
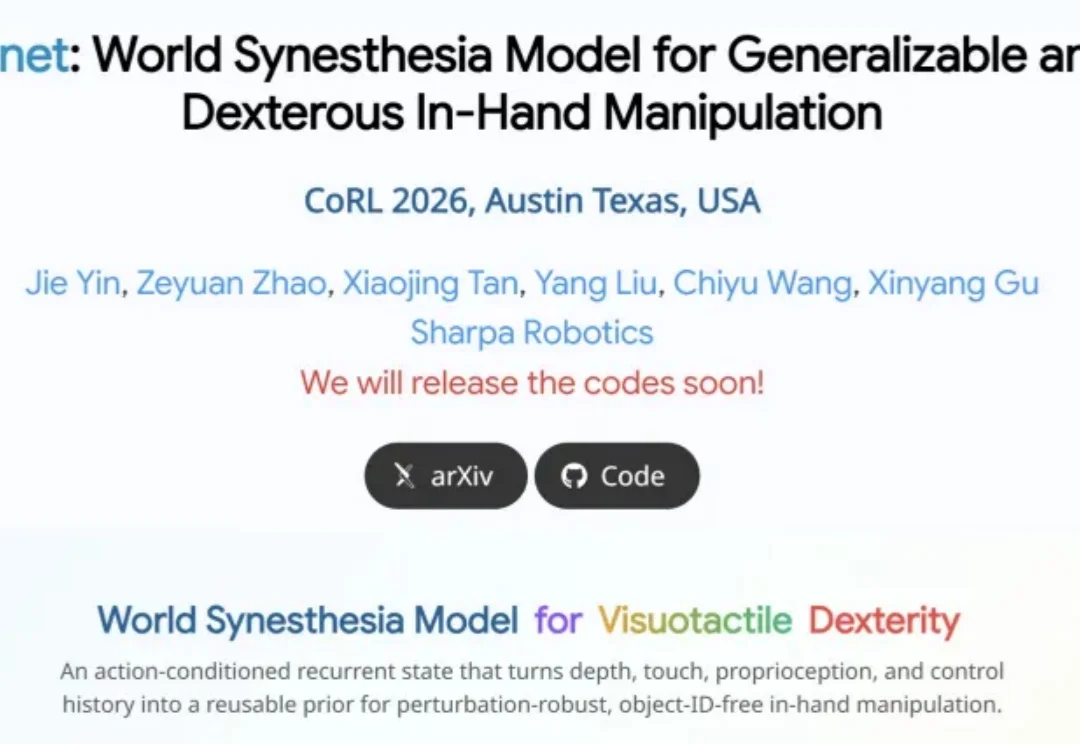
灵巧手从 demo 走向真实应用,关键不只是 “会不会动”,而是能否在 noisy depth、稀疏触觉、外力扰动和未见物体下稳定泛化。现有 in-hand manipulation 往往依赖固定物体、定初始位姿或理想传感器。而一旦遇到真实深度噪声、形状变化和接触状态不可见,这些策略就容易退化成近乎开环的 “手指套路”。
长期以来,机器人系统大多依赖专有模型。
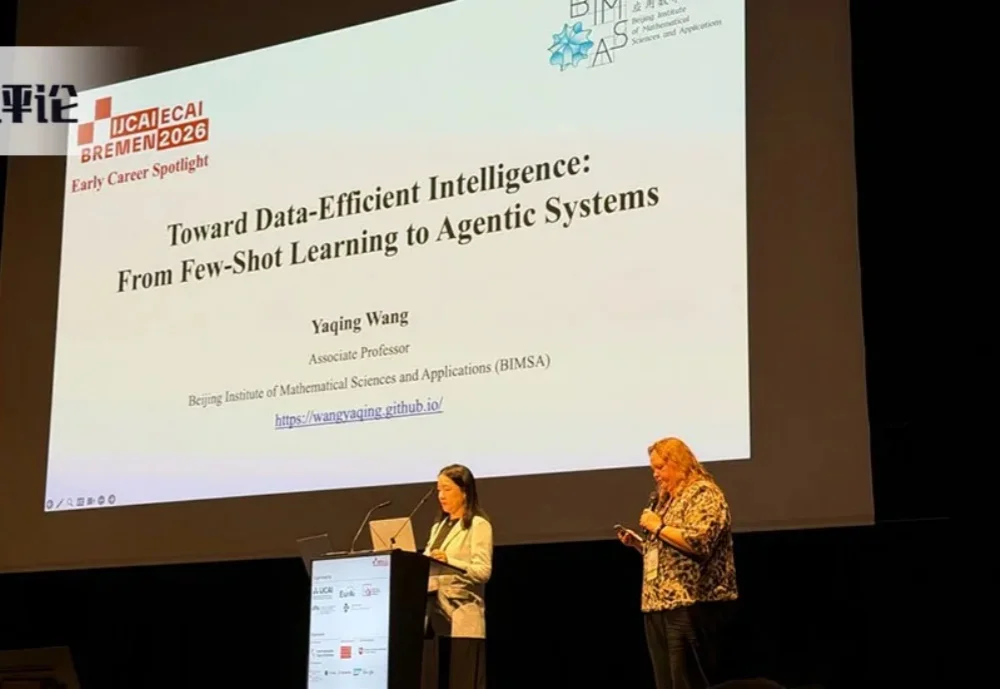
真正的智能,在于能否基于有限的数据,实现可靠的泛化与迁移。
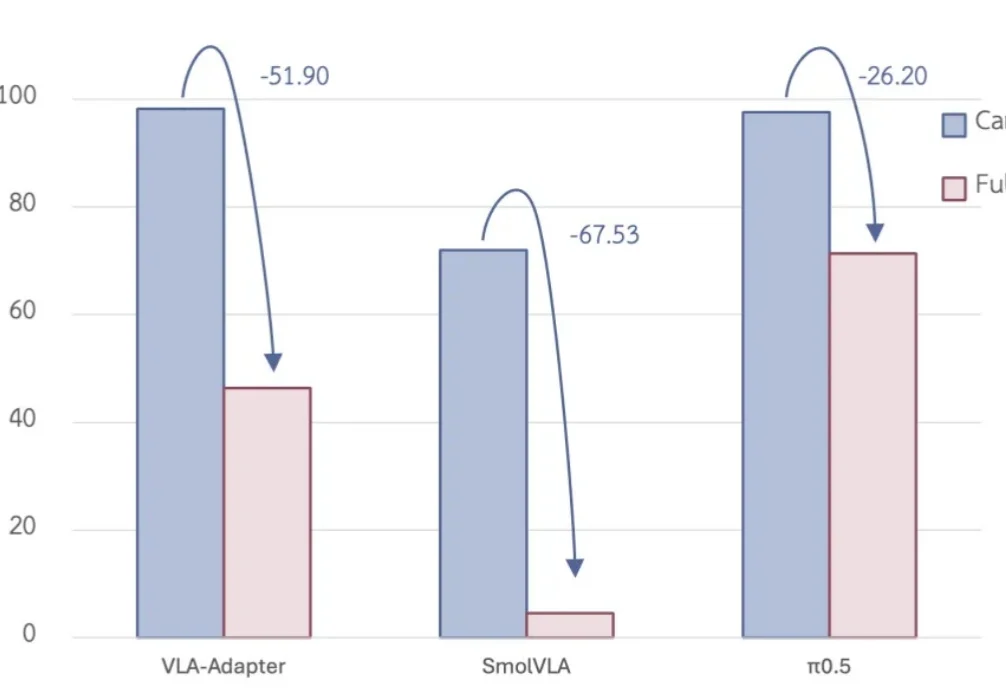
作为具身智能最主流的路线之一,VLA 快速发展的同时也因为其各种问题被诟病。其中最主要的痛点之一便是指令泛化能力。
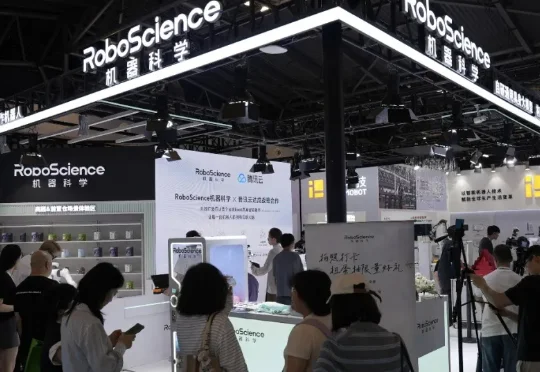
RoboScience机器科学直接把世博馆展台,变成了 Visics 的压力测试场。换本体、换物品、换任务,多轮挑战轮番上阵,专挑具身大模型最容易掉链子的地方下手。Visics 的泛化能力究竟行不行?现场观众可以直接点题,围观验货。
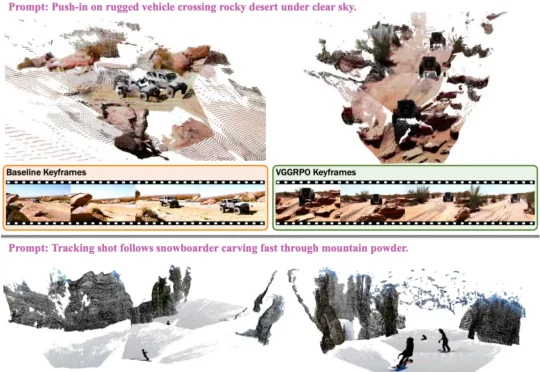
最近,来自 Google、哥本哈根大学、牛津大学等机构的研究者提出了 VGGRPO(Visual Geometry GRPO,收录于 ECCV 2026)。这项工作聚焦于一个核心问题:如何在不牺牲预训练模型泛化能力的前提下,高效地提升视频生成的几何一致性,并使其适用于动态场景。其核心思路是,在隐空间(latent space)中利用 4D 几何奖励,进行几何感知的视频后训练。
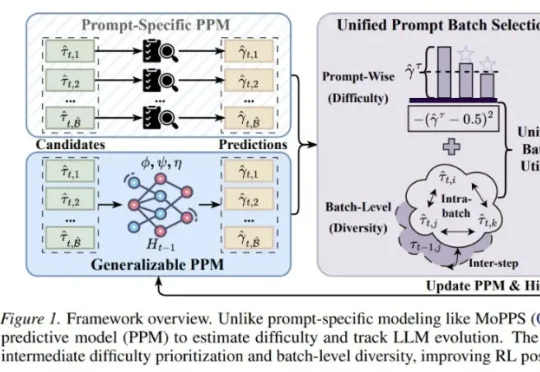
来自清华大学与腾讯的研究者提出了 Generalizable Predictive Prompt Selection(GPS)。GPS 的做法很直接:先训练一个小型、可泛化的 Prompt Predictive Model(PPM),让它预测不同 prompt 在当前模型下的难度;再根据难度和 batch 多样性选择训练样本,从而减少无效 rollout。