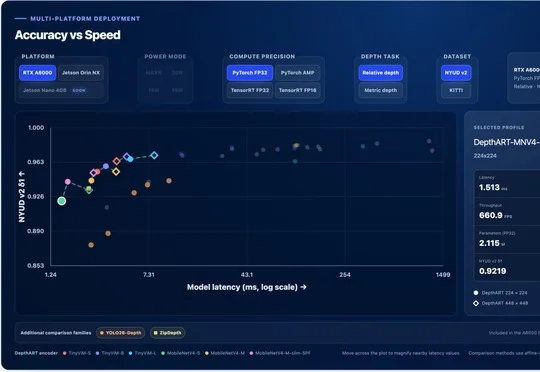
把Depth Anything砍到6M,深度估计终于能跑进Jetson
把Depth Anything砍到6M,深度估计终于能跑进Jetson论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
来自主题: AI技术研报
9097 点击 2026-10-03 10:28

 搜索
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
长期以来,机器人系统大多依赖专有模型。
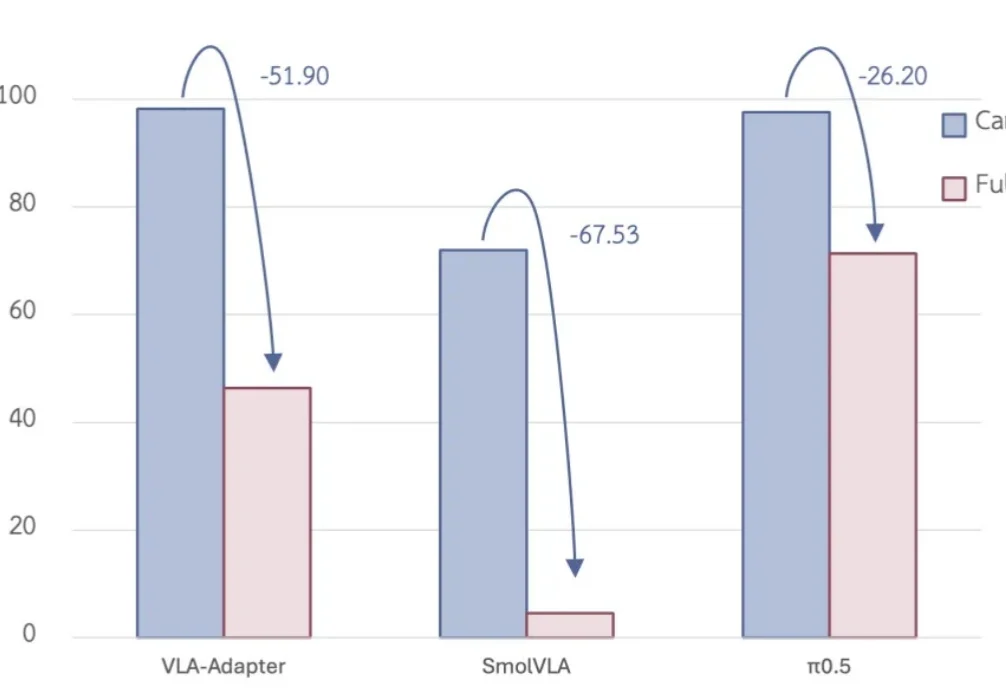
作为具身智能最主流的路线之一,VLA 快速发展的同时也因为其各种问题被诟病。其中最主要的痛点之一便是指令泛化能力。
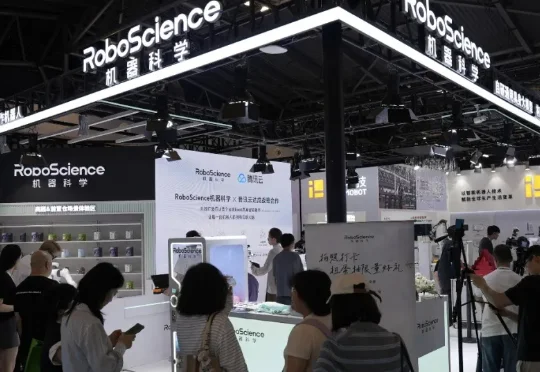
RoboScience机器科学直接把世博馆展台,变成了 Visics 的压力测试场。换本体、换物品、换任务,多轮挑战轮番上阵,专挑具身大模型最容易掉链子的地方下手。Visics 的泛化能力究竟行不行?现场观众可以直接点题,围观验货。
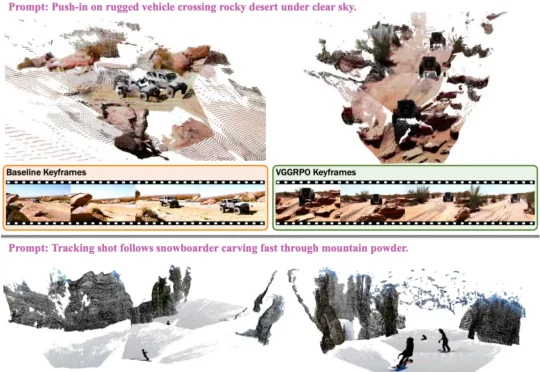
最近,来自 Google、哥本哈根大学、牛津大学等机构的研究者提出了 VGGRPO(Visual Geometry GRPO,收录于 ECCV 2026)。这项工作聚焦于一个核心问题:如何在不牺牲预训练模型泛化能力的前提下,高效地提升视频生成的几何一致性,并使其适用于动态场景。其核心思路是,在隐空间(latent space)中利用 4D 几何奖励,进行几何感知的视频后训练。
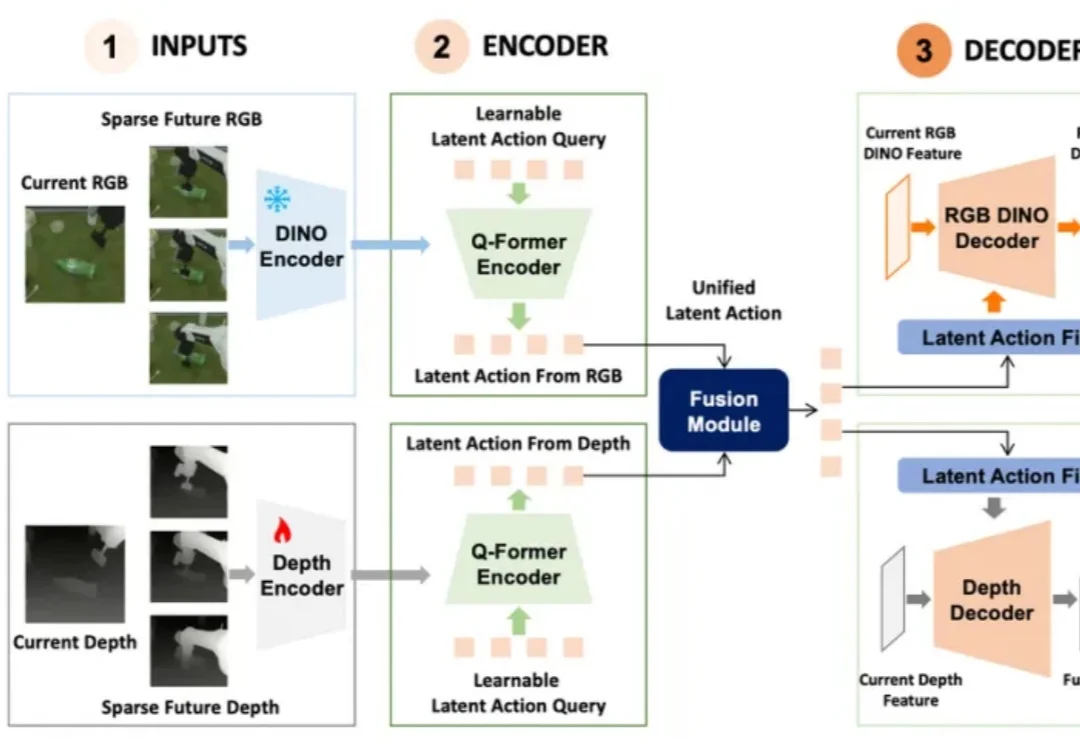
Yann LeCun的JEPA架构很可能不会work,但至少证明了隐空间比像素或文本空间具备更强的泛化能力;
当前,物理 AI 正面临着关于泛化能力的普遍质疑。当模型缺乏对真实物理规律的深度认知、难以跨越复杂多变的开放场景时,如何让机器人真正理解物理世界并精准规划决策,已成为具身智能破局的关键。
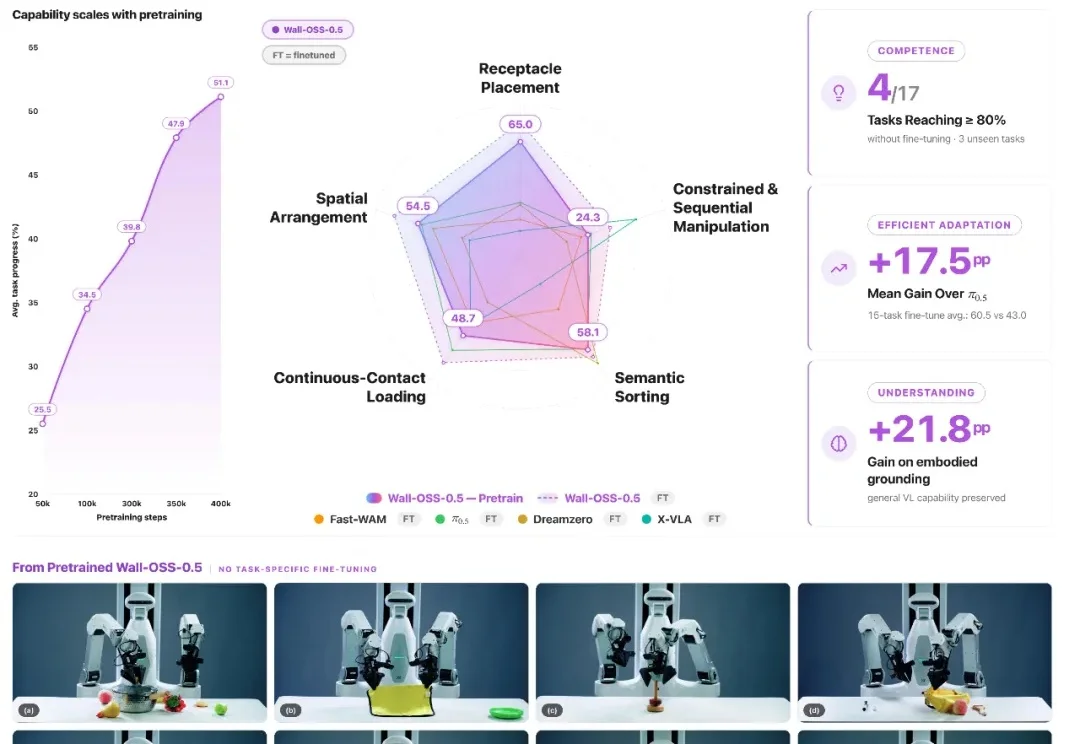
2026 年初,国内具身智能赛道掀起了一波开源潮,越来越多团队开始公开自己的视觉-语言-动作(VLA)模型、数据集与训练框架。与此同时,行业竞争也逐渐集中到 benchmark 成绩、任务成功率以及跨任务泛化能力上,尤其是在标准化或已训练任务中的表现。
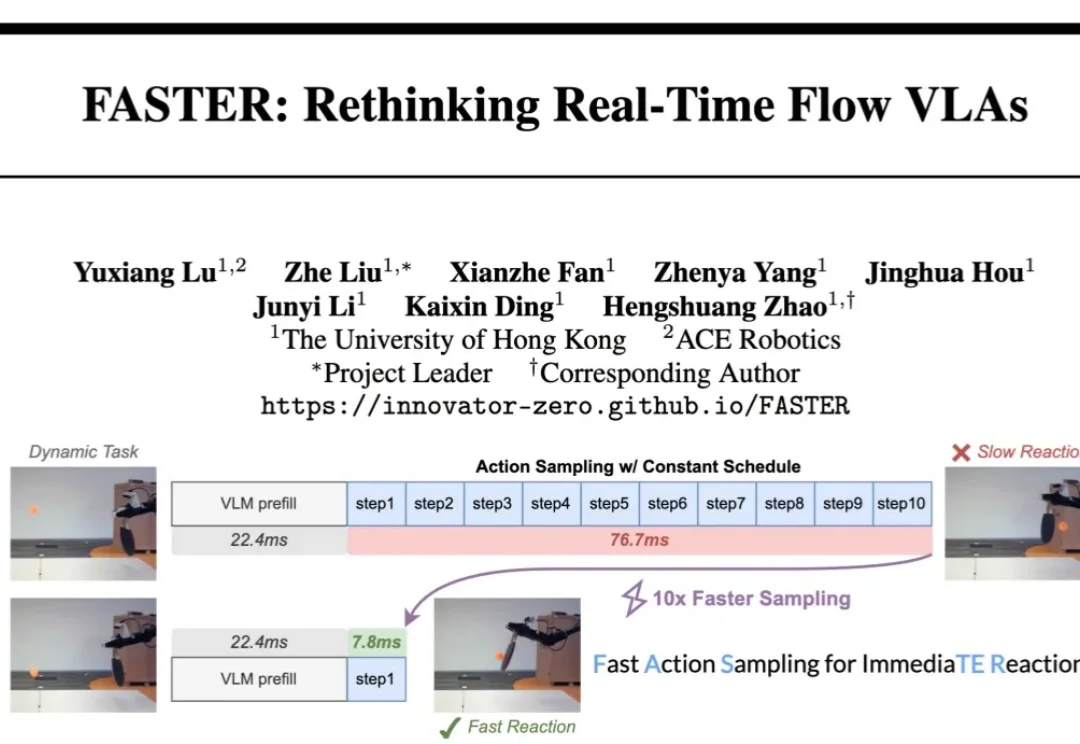
具身智能正以前所未有的速度发展,VLA 模型展现出越来越强的动作和泛化能力。然而,当我们真正把 VLA 模型部署到物理世界时,一个核心挑战浮出水面:实时性。
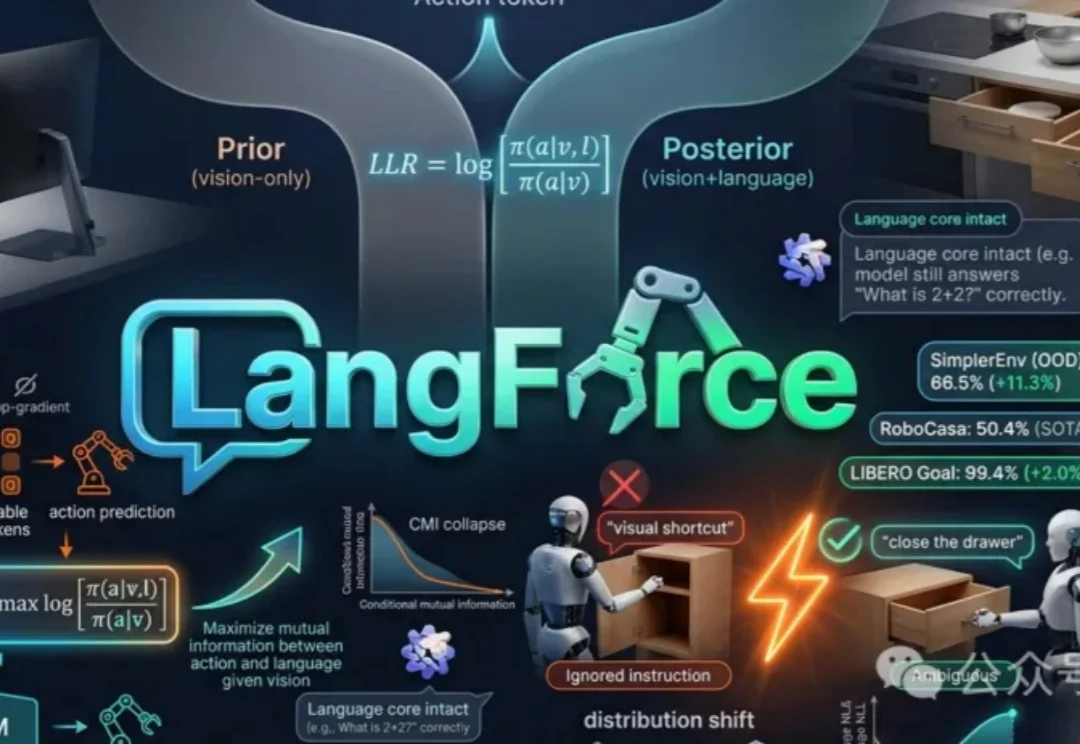
当前VLA模型常依赖视觉线索而非语言指令,导致在新场景下表现不佳。论文提出LangForce方法,通过引入对数似然比损失,强化模型对语言的依赖,提升其在分布外环境中的泛化能力,并保留语言核心功能。