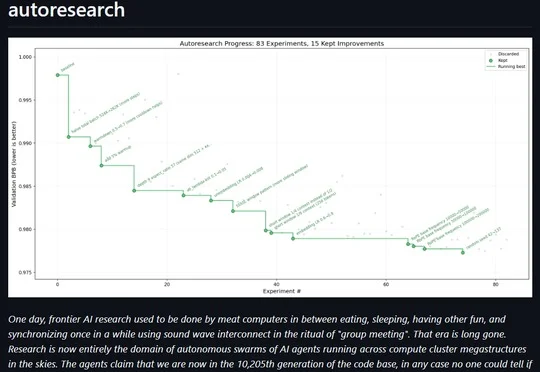
当AI开始造AI:递归自我改进的2026年
当AI开始造AI:递归自我改进的2026年2026年,Anthropic披露Claude已主导26%的研发,OpenAI宣布自动化研究实习生达标,智谱与MiniMax推进工程优化,但Weco AI的AIDE²实验尚未证明系统能提升自我改进能力。
来自主题: AI资讯
8979 点击 2026-10-10 15:31

 搜索
2026年,Anthropic披露Claude已主导26%的研发,OpenAI宣布自动化研究实习生达标,智谱与MiniMax推进工程优化,但Weco AI的AIDE²实验尚未证明系统能提升自我改进能力。
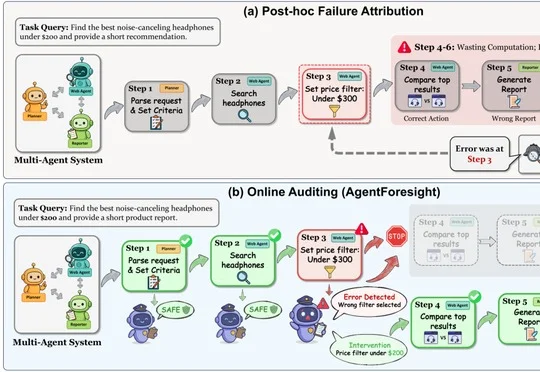
研究团队提出7B审计员AgentForesight,可在多智能体任务运行中在线识别并归因关键错误,其AFTraj-2K Exact-F1达66.44,成功轨迹误报率仅2.37%。
TypeSafe AI完成8.7亿美元A轮融资,投后估值达75亿美元,由a16z领投,其可直接写入代码的决策模型Jev上线后迅速增长。
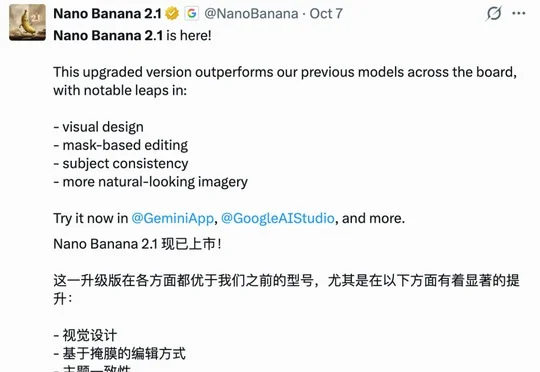
谷歌发布Nano Banana 2.1生图模型,支持4K直出、蒙版编辑和背景替换,中文渲染改善、API价格降低,但连续编辑仍存在水印和画质下降问题。
扩散智能DiffuSpace连续完成两轮融资,总金额达数亿元,由经纬创投、顺为资本、君联资本联合领投,创下全球扩散语言模型(dLLM)最大规模融资纪录。
英伟达联合MIT和牛津大学团队提出Physis-Lang,通过物理语言描述、自进化准则和能力导向的数据检索提升视频模型的物理理解与生成表现,其Cosmos3-Super和Cosmos3-Nano在Physics-IQ Verified分列第一、第二。
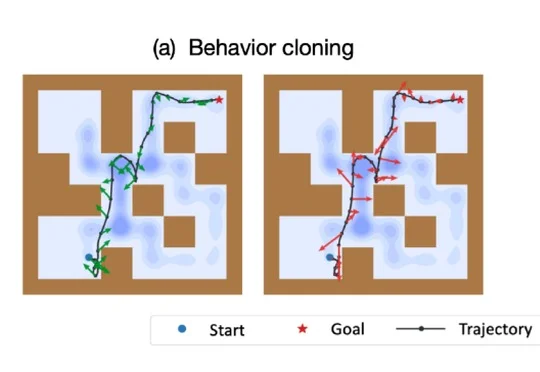
清华大学智能产业研究院(AIR)的一项NeurIPS 2026录用工作提出高阶动作监督,无需改动策略网络即可约束动作的一阶时序变化,并在OGBench及约1%数据的D4RL实验中提升小样本性能与动作平滑性。
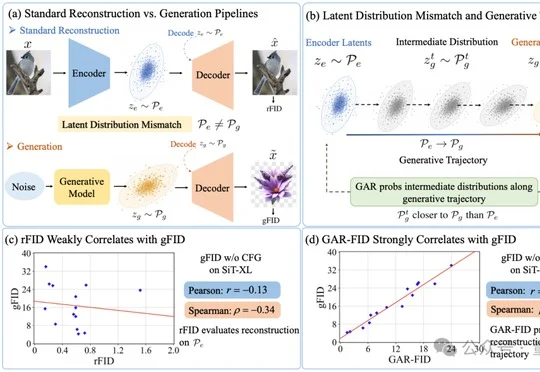
让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
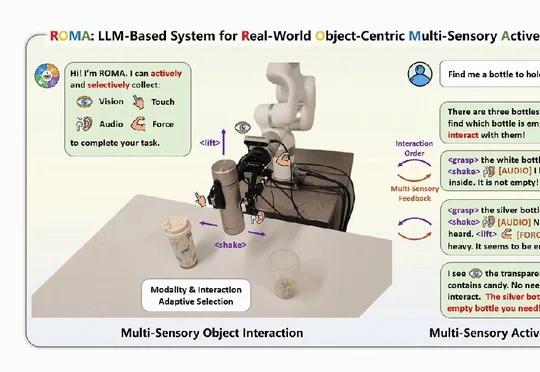
人大高瓴 GeWu-Lab、智源研究院与燧行 AresoX 等机构提出 ROMA,构建 ROMI-2K、ROMA Bench 及 ROMA-7B,使机器人融合视听触力主动探索物体,并在 ROMA Bench 上以 72.9% 总体任务成功率基本追平 GPT-6 Astra。
Anthropic将在11月12日起生效的Claude使用政策中,禁止用户对Claude模型实施持续且不必要的虐待或残忍行为,主要由模型终止对话作为执法手段。