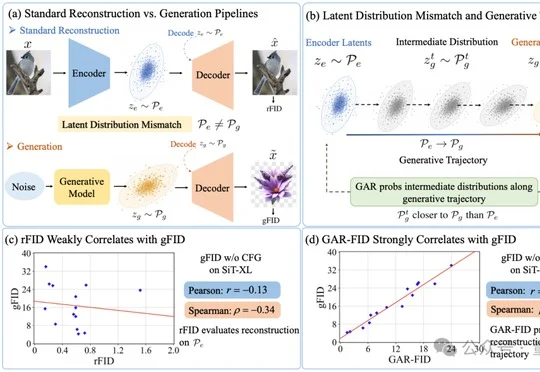
图像生成模型调优新思路:让解码器“提前适应”生成器的潜变量
图像生成模型调优新思路:让解码器“提前适应”生成器的潜变量让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
来自主题: AI技术研报
9037 点击 2026-10-10 12:34

 搜索
让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
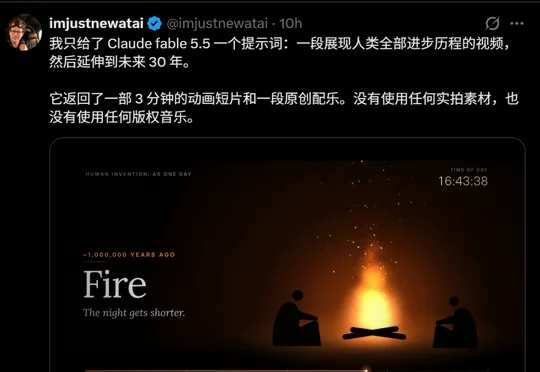
今天,外网被这个视频刷屏了。有人用Fable 5.5一键生成了一部「人类数万年进化史」,把整个人类历史压缩进了3分钟。整个过程,都是用纯代码写出,零视频素材,零版权音乐,没有使用任何视频生成模型。
TaoMate-H3 是由阿里巴巴 TaoLive AIGC 团队研发的音视频联合流式生成模型。基于 MiniMax H3,TaoMate-H3 将三步 LoRA 推理与自回归生成相结合,能够根据文本
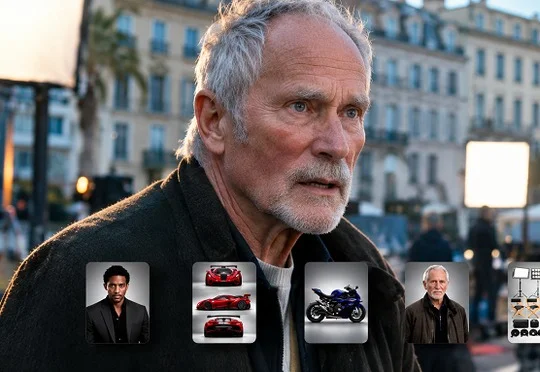
可灵AI发布时隔8个月大版本更新的旗舰视频生成模型Kling 4.0及轻量版Kling 4.0 Flash,单次原生生成时长提升至30秒,最多支持10个关键帧输入,新增双通道立体声输出,并将很快推出4K 10-bit HDR格式。
虎鲸文娱在云栖大会发布行业首个AI影视制作与管理平台"鲸锐AI",聚焦制作过程可控、结果可交付、成本可管理,旨在补足生成模型与专业影视生产之间缺失的工业化生产层基础设施。
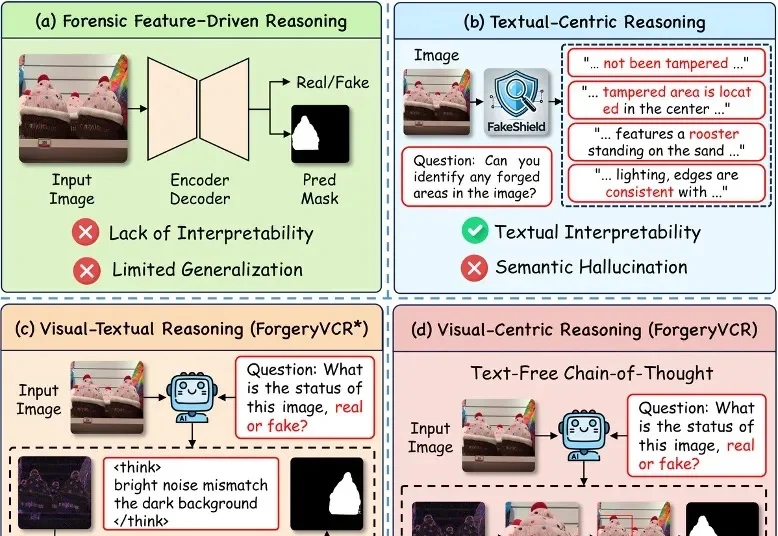
随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。
给生成模型引入仿真,补上难以获得的声音感知。
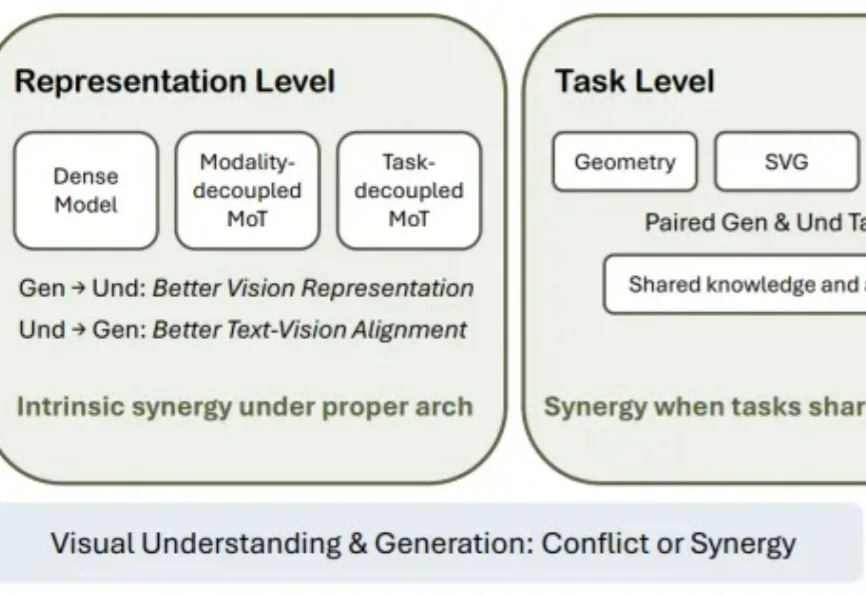
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
OpenAI发布新一代图像生成模型ChatGPT Images 2.5,在图片细节质量、生成速度、编辑精度及多轮修改一致性上有所提升,并新增Sketch手绘参考、创作模板和图片评论编辑等功能。
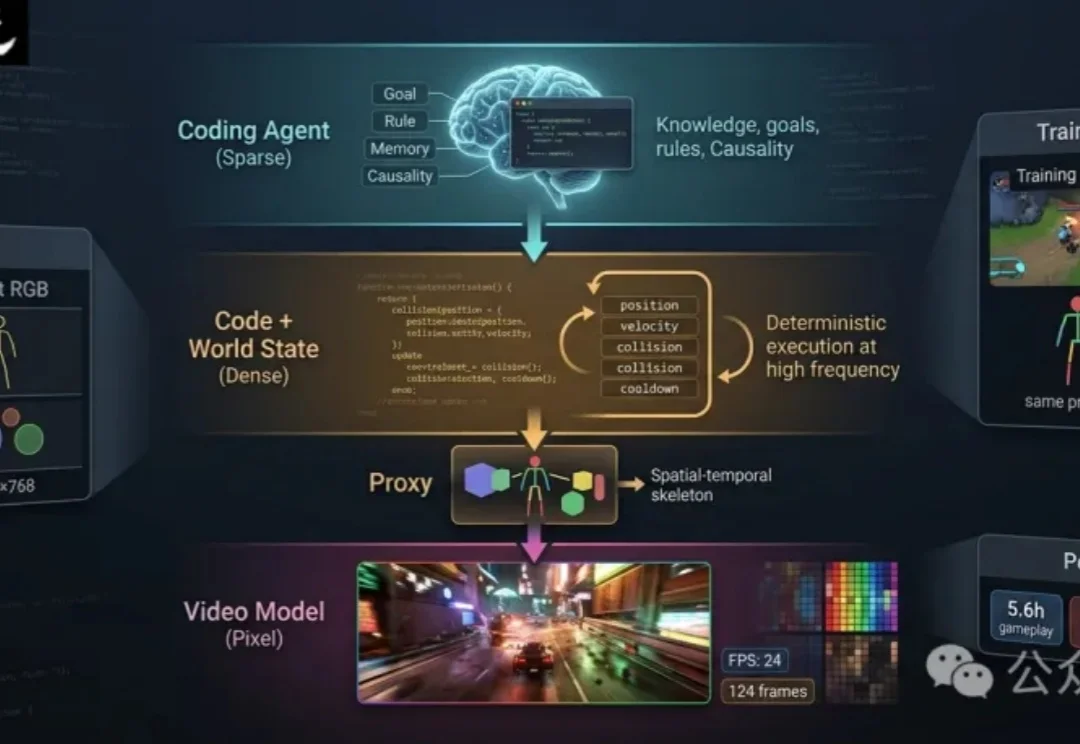
近年来,视频生成模型在清晰度、时序一致性和可控性上快速进步。给定文本、图像、相机轨迹或玩家动作,模型已经能够合成连贯的后续画面,也让「可交互视频世界」逐渐从概念走向可观看、可操作的原型。